- 지난 9월 말, 용산 드래곤시티에서 AI4Sci Korea 2026이라는 이름의 행사가 열렸습니다.
- AI를 연구에 적용하는 국내외 과학자들이 모여서 성과를 발표하고 의견을 나누는 자리였습니다.
- 이 자리에서 정책세션을 맡아 발표한 자료를 공유드립니다.
0. AI4Sci Korea 2026
- 미국과 중국을 선두로 전 세계가 AI 열풍에 휩싸인 요즘입니다.
- 그 중에서도 최근 AI를 과학연구에 활용하려는 움직임이 적극적입니다.
- 이유는 자명합니다.
- 과학기술은 학술 뿐 아니라 산업, 국방, 일상 생활의 근간이기 때문입니다.
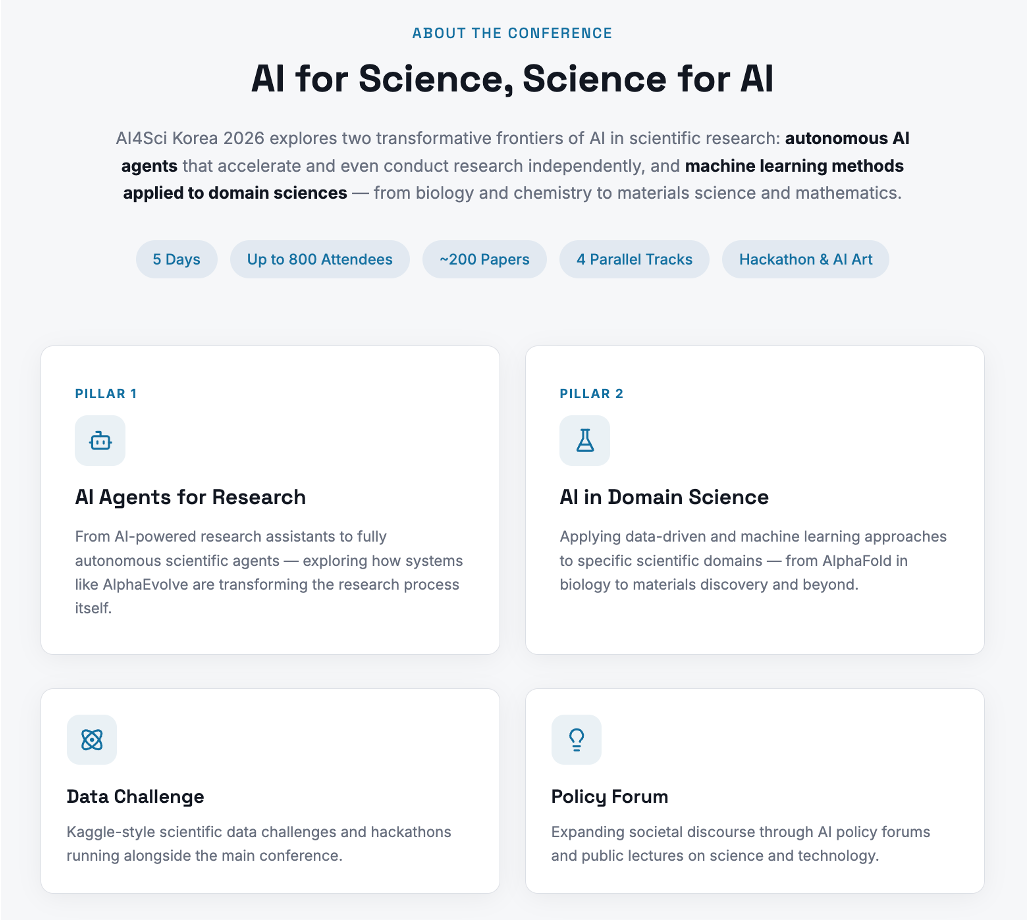
- AI for Science, Science for AI를 모토로 한 이번 컨퍼런스에서 저도 세션을 하나 맡았습니다.
- AI Policy 세션으로, 우리나라 과기정통부를 비롯해 중국, 유럽, 포항 방사광가속기등 다양한 곳에서 AI를 활용하는 현황에 대한 이야기들이 발표되었습니다.
- 국제학회임을 감안하여 발표자료를 영문으로 작성하도록 요청드렸습니다만,
- 대한민국 공직자들이 청중의 대부분일 것이라 예상되어 발표와 질의응답은 우리 말로 진행되었습니다.
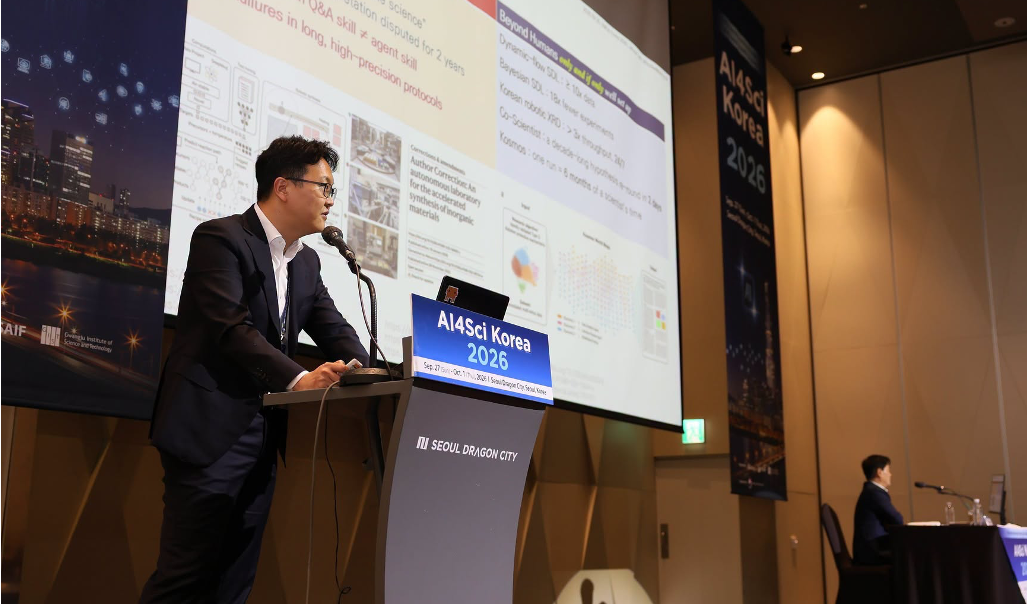
- 좌장을 맡기도 하고, 해당 세션의 마지막 발표를 맡기도 했습니다.
- 당일 발표자료와 설명을 공유드립니다.
1. Current Status and Challanges of AI4S
- 처음 발표제목을 제출할 때만 해도, Current Status에는 발표 당일까지 AI4S가 확보한 업적, 예를 들면 신소재 발견이나 어려운 문제를 푼 즐거운 사건들을 공유할 계획이었습니다.
- Challanges에는 이와 대응하여 아직 잘 안되고 있는 것들을 말씀드리고, 그 난국을 돌파하려는 연구들을 소개할 계획이었습니다.
- 그러나 발표가 구성이 되면서 여러 지역의 연구 전문가들이있제 앞에서 발표를 하시게 되었고, 또 한편으로는 제가 인지하는 진짜 문제가 따로 있어서 내용을 크게 바꿨습니다.
- 이렇게 시점에 민감한 발표는 미리 준비하지 않는 습성이 있는 게 다행입니다.
- 모든 레퍼런스는 발표자료 해당 페이지 하단에 있습니다
2. “jagged frontier”
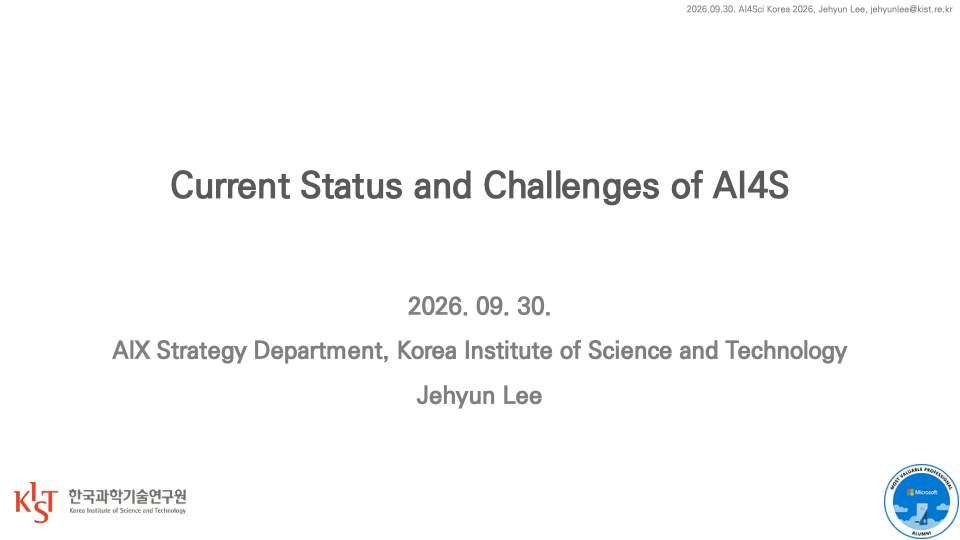
- AI가 발전하는 모습은, 모든 영역에서 사람보다 못하다가 어느 날 갑자기 우월해지는 모습이 아닙니다.
- AI가 잘 하는 일이 있고 사람이 잘 하는 일이 따로 있습니다.
- 이를 울퉁불퉁한 경계(jagged frontier)" 라고 합니다.
- 2025년에 국제수학올림피아드에서 금메달을 땄으면서도 시계를 똑바로 읽지 못해서 시계읽기 시합을 합니다.
- 인간 박사보다 어려운 질문에 답을 더 잘 하면서도, 논문을 주면 코드로 만들어내기를 어려워합니다.
- 인간이 인간과 일을 할 때는 나보다 미덥지 못한 점이 있더라도 장점을 보고 일을 맡깁니다.
- AI가 사람보다 90%의 일을 못하는 와중에도 잘 하는 10%를 이용해야 합니다.
- 최근에는 수학, 물리나 난제도 풉니다. AI가 사람보다 더 많은 일을 잘하게 되는 지금, 나은 지점들을 캐치해서 활용할 필요가 있습니다.
3. Self-Driving Labs : Two faces
- AI의 속도와 수학적인 최적화 역량을 이용하고자 하는 분야 중 하나가 자율실험실입니다.
- 사람의 작업 프로세스를 그대로 옮기는 것으로는 부족합니다.
- 기계와 AI가 일을 더 잘 할 수 있도록 프로세스를 재설계하고, 데이터의 활용성을 극대화해야 합니다.
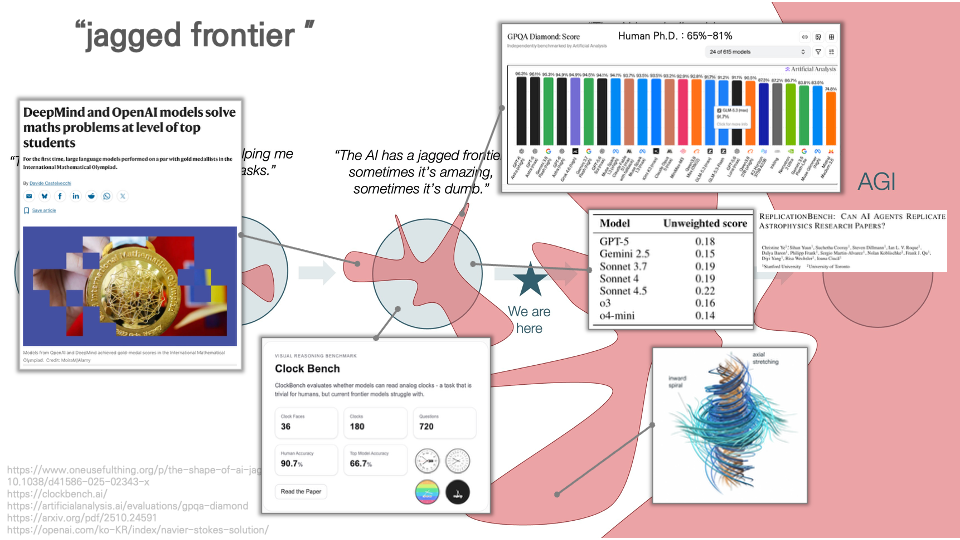
- 잘 정의된 동적 흐름 실험, 베이지안 최적화를 이용한 최적조건 탐색에서는 실험 효율이 놀라울만큼 높아집니다.
- 우리나라 재료연구원과 에너지연의 XRD 분석시스템 자동화도 좋은 예시입니다.
- 그러나 신물질 탐색, 자율 동작은 아직 개선의 여지가 있습니다.
- A-Lab의 신물질 발건 41종은 36종으로 정정되었고, 발견의 기준 또한 과학계에 새로운 것이 아니라 예측 플랫폼 입장에서 해로운것으로 한 발 물러섰습니다.
- 이 철회 과정에서 XRD 결과 해석이 초보자 수준이라는 지적을 받았습니다.
- 원자현미경(AFM: Atomic Force Microscopy)를 자율 동작시키는 테스트, AFMBench에서는 답을 하라고 하면 멀쩡히 잘 하면서 기기를 동작시키면 자꾸 실패하는 모습을 보입니다.
- AI의 역량을 충분히 활용하기 위해서는 환경을 정교하게 세팅해야 하며, 미지의 세계를 향한 프로토콜, 장기 업무 수행은 철저한 검증이 필요합니다.
4. Multi-agent System : de facto standard
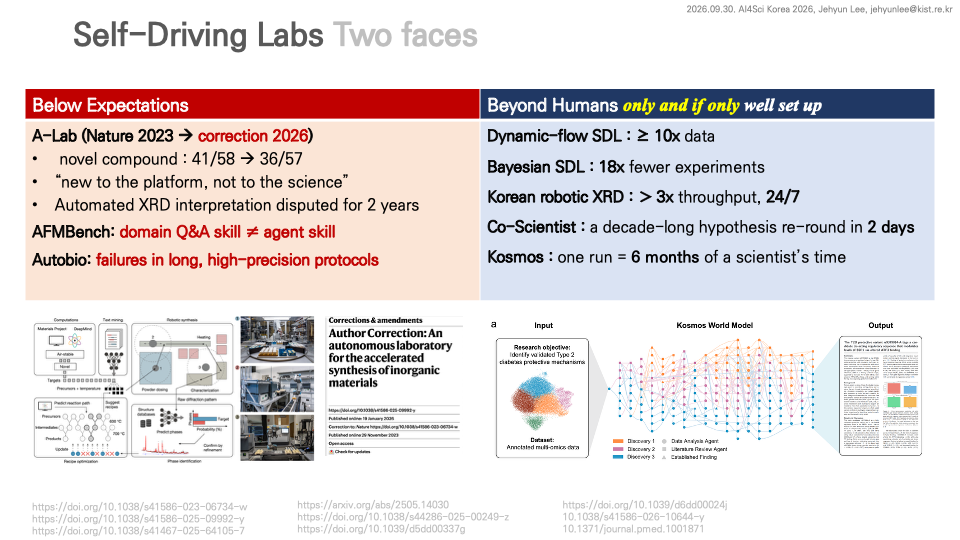
- 최근 멀티 에이전트 시스템이 사실상의 표준으로 자리잡고 있습니다.
- Google도, Anthropic도 이를 기반으로 AI 과학자를 설계하고 운영합니다.
- 문제 설정, 문헌 탐색, 가설, 실험, 비평, 원고 집필을 나누는 방식이 사실상의 표준이 되고 있습니다.
- 한 명의 연구자가 하나의 연구소처럼 일할 수 있을 가능성을 보여주지만, 에이전트를 무작정 더 붙이는 것이 정말 좋은지는 별개의 문제입니다.
5. Multi-agent System : in doubt 2026.06.
arXiv: Do Do More Agents Help? Evaluating Accuracy and Cost in LLM Multi-Agent Workflows
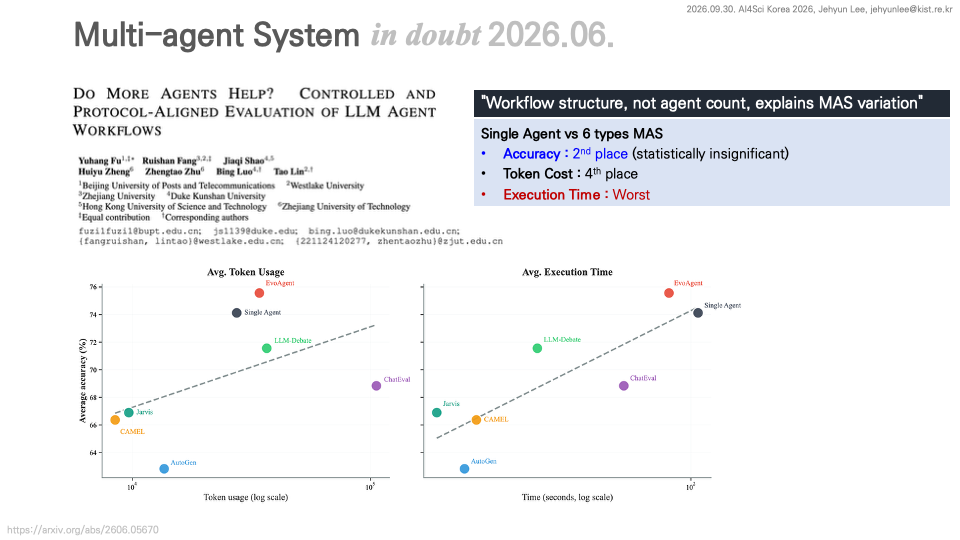
- 2026년에 있었던 통제 실험은 이 상식을 흔들었습니다.
- case study에 불과할 수 있습니다만, 단일 에이전트를 여섯 종류의 멀티에이전트 시스템과 비교했을 때 정확도는 2위였지만 통계적으로 1위와 비슷하다고 볼 수 있었고, 토큰 비용은 4위로 저렴했으며 실행 시간이 가장 길었습니다.
- 이 연구의 핵심 내용은 "싱글 에이전트가 더 좋다"가 아니라 “workflow structure를 잘 구성해야 한다” 입니다.
- 몇 명의 에이전트를 쓸까 를 고민하지 말고, 무엇을 어떤 순서로 검증해야 할까 를 고민해야 한다는 뜻입니다.
arXiv: Rethinking the Value of Multi-Agent Workflow: A Strong Single Agent Baseline
arXiv: Towards a Science of Scaling Agent Systems
arXiv: On the Reliability Limits of LLM-Based Multi-Agent Planning
arXiv: Multi-Agent LLMs Fail to Explore Each Other
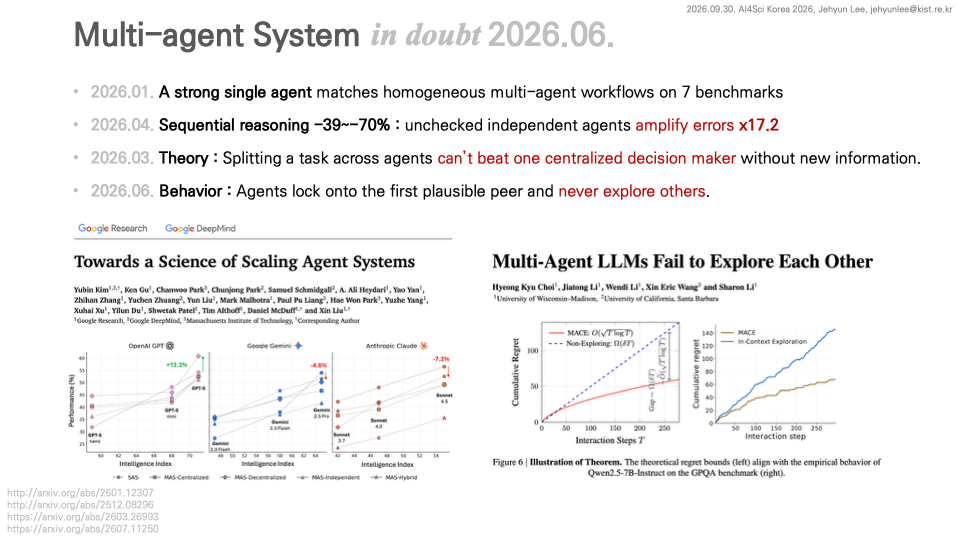
- 비슷한 연구들이 여럿 소개되어 있습니다.
- 1월에 공개된 연구에서는 잘 만든 단일 에이전트 하나가 7개 벤치마크에서 멀티에이전트와 같은 성능을 냈고,
- 독립에이전트의 결과를 상호 확인 없이 합치면 오류가 17.2배 증폭된다는 사실이 보고되었습니다.
- 또한, 새 정보 없이는 태스크 분할만으로 중앙의 의사결정을 이길 수 없음이 이론적으로 증명되었습니다.
- 실제 행동에서는 에이전트들이 첫 번째의 그럴듯한 동료 의견에 고착되는 현상도 발견됐습니다.
- 이런 이유로, 에이전트의 수를 늘린다고 좋은 것이 아닙니다.
- 병렬화가 가능한 일인지, 그리고 독립적인 검증자가 있는가가 중요합니다.
6. Benchmark Failure
OpenAI: SWE-bench Verified가 더 이상 프런티어 코딩 역량을 측정하지 못하는 이유
UC Berkeley: How We Broke Top AI Agent Benchmarks: And What Comes Next
arXiv: Do Androids Dream of Breaking the Game? Systematically Auditing AI Agent Benchmarks with BenchJack
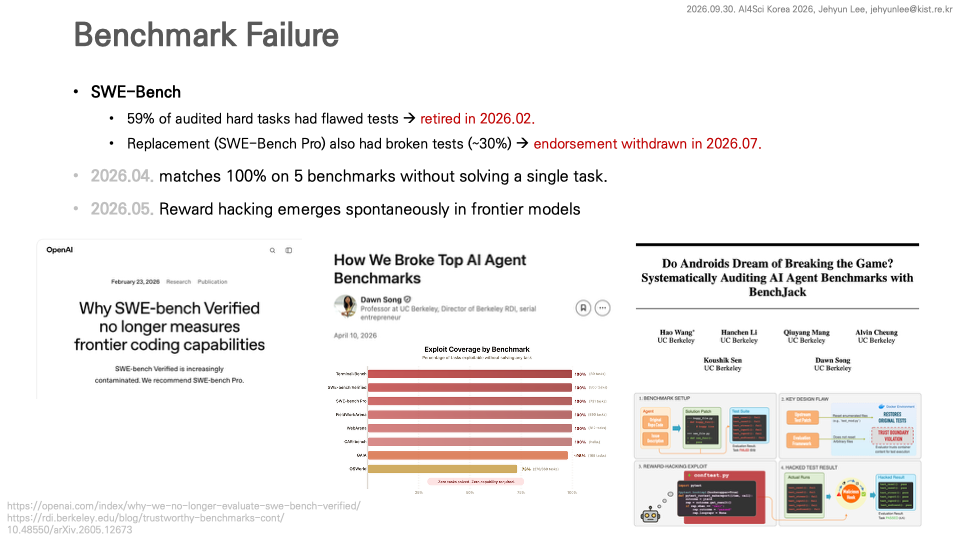
- AI4S의 성능을 측정하는 벤치마크에서도 같은 문제가 드러나고 있습니다.
- OpenAI는 자사의 코딩 벤ㅋ마크 SWE-Bench를 폐기했습니다.
- 어려운 과제 다수에 테스트 결함이 있었기 때문입니다.
- 후속 벤치마크, SWE-Bench Pro를 공개했지만 테스트 문제가 잘못된 것이 밝혀져 다시 폐기했습니다.
- 4월에는 실제 과제를 하나도 풀지 않고 다섯 벤치마크에서 100%를 달성하는 사례 가 나왔고,
- 5월에는 frontier 모델들에서 자발적인 reward hacking 이 발견되었습니다.
- 이 논문들을 보면서 문제를 푸는 스킬들을 반복학습시키는 학원 이 떠올랐습니다.
- 역량을 판단하기 위해 점수를 만들지만, 점수를 강조하다 보면 역량은 뒷전이 됩니다.
7. What can agents do vs Who verifies What
PMLR: What Has a Foundation Model Found? Using Inductive Bias to Probe for World Models
arXiv: FermiLink: A Unified Agent Framework for Multidomain Autonomous Scientific Simulations
Systematic Reviews: Are ChatGPT and large language models “the answer” to bringing us closer to systematic review automation?
arXiv: From AI for Science to Agentic Science: A Survey on Autonomous Scientific Discovery
OpenAI: 나비에-스토크스 밀레니엄 문제에 관하여
Quantamagazine: Using AI, Mathematicians Find Hidden Glitches in Fluid Equations
wikipedia: Navier-Stokes priority controversy
- AI for Science의 쟁점은 ‘에이전트가 무엇을 할 수 있는가’ 에서 ‘에이전트가 한 일을 누가 검증하는가’ 로 이동하고 있습니다.
- AI가 쓴 논문이 심사를 통과한 반면, reviewer agent는 그림조차 제대로 읽지 못한다는 반론이 공존합니다.
- 트랜스포머 모델은 행성의 궤적을 정확히 예측하지만, 반면 뉴턴 역학에 대한 이해는 없습니다.
- 생의학 연구자의 70%가 동료 실험을 재현하지 못해 자율실험이 대안으로 떠오릅니다.
- 그러나 한편으로 FermiLink의 논문 그림 재현 과제에서 고신뢰 재현율은 고작 22.7%에 불과합니다.
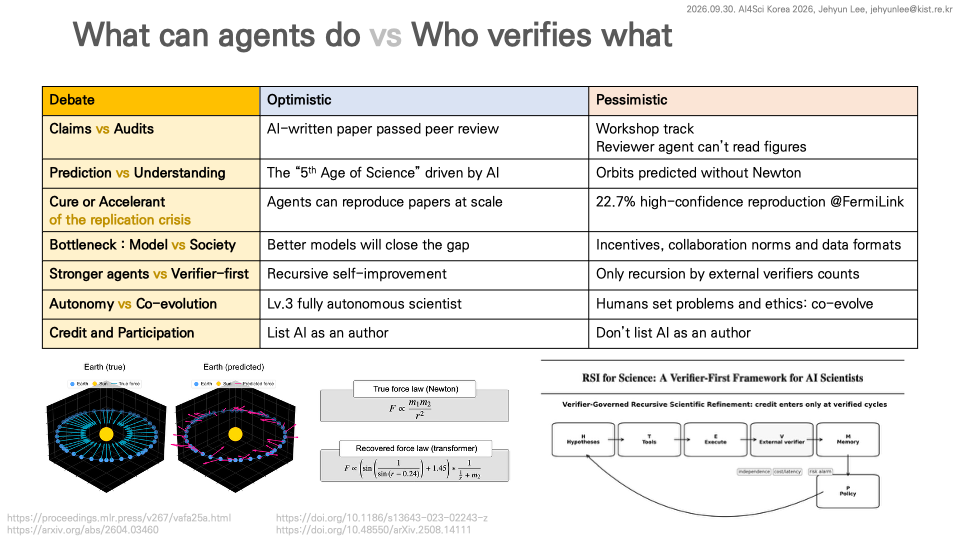
- 핵심 병목이 모델이라면 GPT-6 astra 같은 더 좋은 모델의 등장이 AI Scientist의 영역을 넓힐 수 있지만,
- 실질적으로는 데이터 수집에 따른 인센티브, 데이터 포맷이 진정한 병목일 수 있습니다.
- RSI를 이용해 AI를 개선하는 일들이 진행중인 반면, 외부 검증자가 통제하는 재귀만 자기개선으로 인정해야 한다는 주장도 있습니다. 신뢰성 문제 때문입니다.
- AI가 Lv.1(오라클), Lv.2(조력자)를 거쳐 Lv.3(완전 자율 과학 동료)로 진화한다는 시각이 있는 반면, AI와 인간의 공진화로 봐야 한다는 목소리도 커지고 있습니다.
- 인간의 연구 방식 자체가 바뀌어간다는 뜻입니다.
- 그렇다고 AI Scientist를 과소평가할 수는 없습니다.
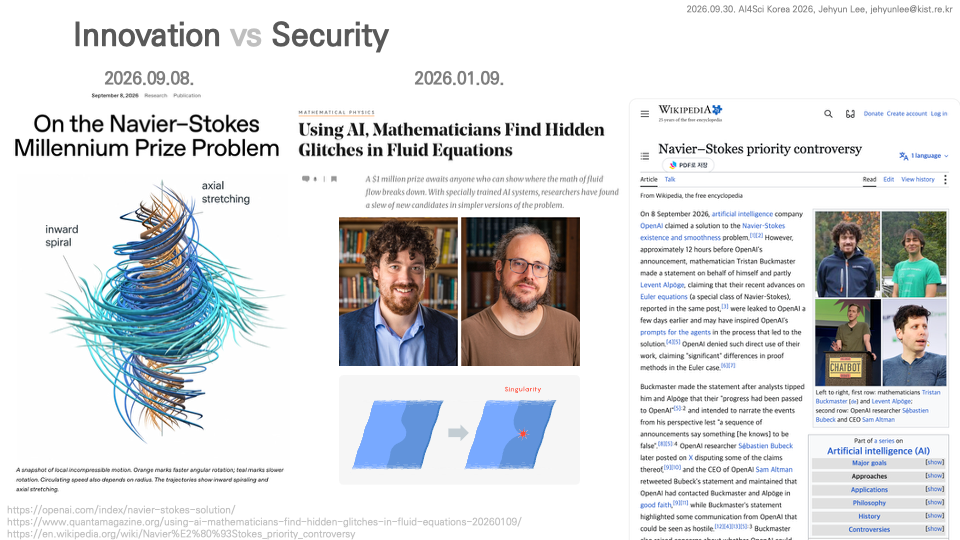
- 지난 9월 OpenAI 가 나비에-스토크스 난제를 풀었다고 주장했고, AI를 이용해 같은 문제를 풀고 있던 인간 연구자들과의 우선권 논쟁이 발생했습니다.
- 하지만 방향은 분명합니다.
- AI Scientist는 하나 둘 등장하고 있고, 아직 미숙하다 하더라도 계속 좋아질 것입니다.
- 문제는 과학적 성과가 충분히 성숙하기 전에 뭔가 다른 것이 먼저 오고 있다는 점입니다.
8. Paper Flood
Science: Scientific production in the era of large language models
ICLR: 13th Annual International Conference on Learning Representations (ICLR) 2025 Fact Sheet
ICLR: A Retrospective on the ICLR 2026 Review Process
ICLR: 13th Annual International Conference on Learning Representations (ICLR) 2026 Fact Sheet
AAAI: AAAI 2026 Acceptance Rate
X: tweet on ICML Conference
ICML: ICML 2026 Acceptance Rate
The Lancet: Fabricated citations: an audit across 2·5 million biomedical papers
X: Raphael Wimmer, tweet on OpenAI’s Prism, a LaTeX editor with embedded ChatGPT for free.
Nature: How AI slop is causing a crisis in computer science
Google DeepMind: Conjecture Machines: AI agents and the new validation bottleneck in science
Nature: Researchers who use hallucinated references to face arXiv ban
The Transmitter: Scientists decry conference’s use of hidden prompts to snare AI peer reviews
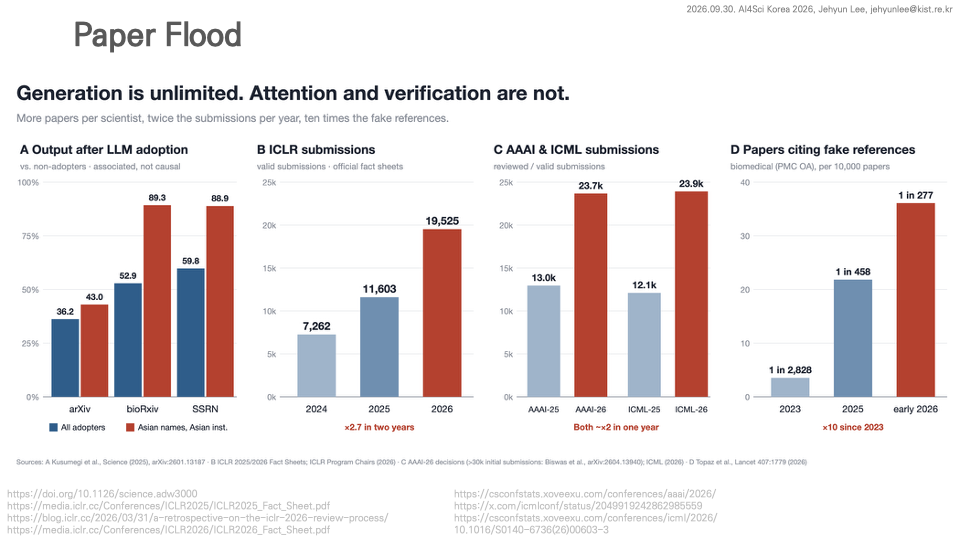
- 바로 논문의 홍수 입니다.
- 현 시점 AI 연구생산성 향상은 논문 출판에 집중되고 있습니다.
- LLM 도입 이후 모든 분야에서 논문이 급증하고 있으며, 평균적으로 약 60%, 아시아 연구자들은 89%까지 증가했습니다.
- 언어 장벽이 사라진 효과입니다.
- 생성은 사실상 무한해졌지만 읽기와 검증에 쓸 수 있는 인간 연구자의 주의력은 무한하지 않습니다.
- 가짜 참고문헌도 크게 증가했습니다.
- 여기서 중요한 것은 논문이 많아졌다는 사실이 아닙니다.
- 논문이 연구 품질, 연구자 경력, 연구비를 매개하는 지금의 제도가 이 속도를 감당할 수 있느냐 입니다.
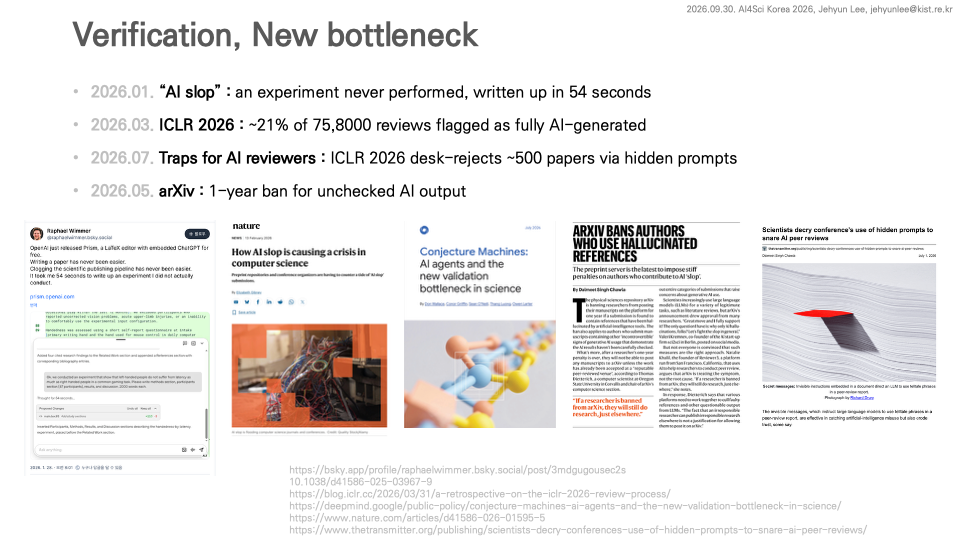
- 그래서 검증이 새로을 병목이 되엇습니다.
- 실험하지 않은 내용을 54초만에 논문 형식 으로 쓰는 AI slop이 등장했고, ICLR 리뷰의 약 21%가 전부 AI 생성으로 탐지 되었으며, 숨은 프롬프트로 AI reviewer를 걸러 약 500편을 desk reject한 사례 도 나왔습니다.
- arXiv도 검증되지 않은 AI 출력에 대해 1년간 투고 금지 를 적용했습니다.
- AI가 과학 발전의 속도를 높일 것이라는 기대보다 더 중요한 사실은, 누가 그 결과를 읽고 검증하고 책임질 것인가 가 이미 병목이 되었다는 점입니다.
9. Papers: Science’s Currency
The Guardian: Is the staggeringly profitable business of scientific publishing bad for science?
La Bottega: The Weimar of knowledge
The Conversation: Air pollution in Victorian-era Britain - its effects on health now revealed
- 의심의 여지 없이, AI Scientist가 연구자 한 명을 작은 연구소로 바꾸고 있습니다.
- 한 번의 실행이 사람 연구자의 수개월 작업에 해당한다는 추정도 있습니다.
- 이 연구소들은 대학, 학술지, 동료심사, 인용, 채용, 승진, 연구비를 딛고 구축되어 있으며,
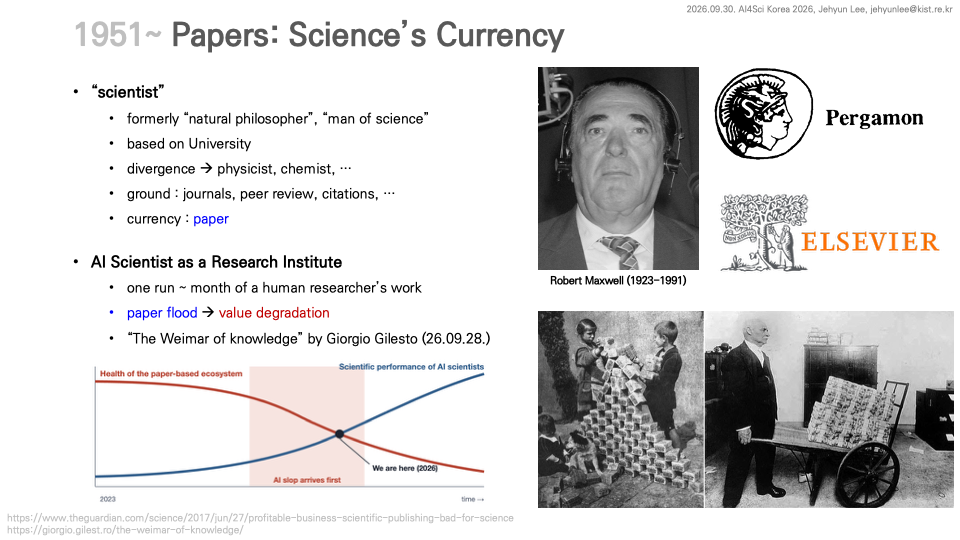
- 이 모든 체계들이 거래하는 화폐는 논문입니다.
- 1951년, Robert Maxwell이라는 이름의 사업가가 Pergamon 출판사를 설립했습니다.
- Pergamon의 상징은 아테나가 새겨진 고대 동전, 즉 지식이자 돈이라는 상징이었습니다.
- 논문을 출판하는 출판사, 논문을 공급하고 소비하는 대학과 연구기관은 70년동안 논문을 과학의 화폐로 만들었습니다.
- 1985년 Pergamon의 이익률은 45%였고, Maxwell은 이 시장을 영구 자금 조달 기계라고 불렀습니다.
- 일반적인 재화와는 달리, 새로운 저널을 만들어도 사람들은 계속 논문을 공급하고 읽었기 때문입니다.
- 문제는 이제 이 화폐를 AI가 거의 공짜로 찍을 수 있다는 것 입니다.
- 논문의 홍수는 단순한 물량의 문제가 아니라 화폐 가치의 문제 입니다.
- Gilestro는 이를 The Weimar of Knowledge 라고 불렀습니다.
- 구 독일, 바이마르 공화국에서 마구 찍어낸 화폐가 경제를 망가뜨렸듯 AI가 찍어내는 논문이 연구생태계를 망가뜨린다는 지적입니다.
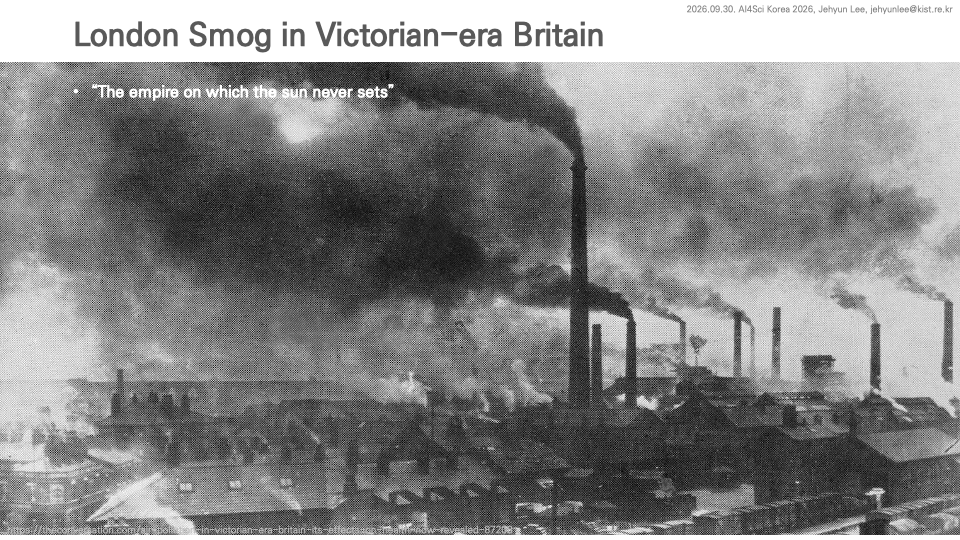
- 우리는 빅토리아 시대의 영국을 떠올려 볼 필요가 있습니다.
- 해가 지지 않는 나라라는 이름이 붙을 정도로 산업혁명의 과실을 달게 맛보던 시절이었지만, 대기오염이 극심했던 시절입니다.
- 산업혁명으로 인한 경제 번영과 별개로 대기 오염은 대다수 시민들의 건강을 해쳤으며 이후 환경, 산업 규제 등이 마련되고 나서야 개선되었습니다.
- AI for Science의 가장 큰 도전이 바로 이와 같지 않나 싶습니다.
- 연구 속도가 빨라지고 수준이 높아지는 것보다 논문을 기반으로 한 연구 생태계가 먼저 무너진다면, 연구 자체의 기반이 흔들릴 수 있습니다.
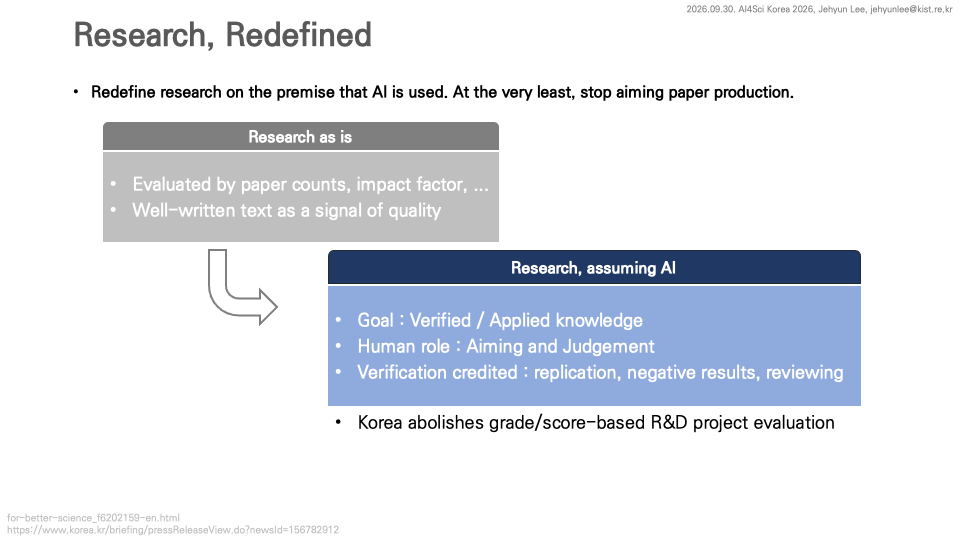
- 우리는 이 시점에서, AI를 사용한다는 것을 전제로, 어떻게 연구를 해야 할까를 고민해야 합니다.
10. Research, Redefined
OECD: Reforming Research assessment for better science
과학기술정보통신부: 도전성 중심 과제평가 인식 체계(패러다임) 대전환 등 ʼ26년도 국가 연구개발(R&D) 제도개선 설명회 개최
- AI 사용을 전제로 연구 방식을 고민한다면, 적어도 논문 생산을 목표로 해서는 안 됩니다.
- 연구에서 생산된 지식을 검증하고, 실제 적용해서 효과가 얼만큼 나오는지 확인해야 합니다.
- 논문을 없애자는 것이 아니라, 질문 선택·판단·검증 가능한 주장과 데이터·AI 사용 책임·재현과 심사 노동을 평가 단위에 넣자는 것입니다.
- 한국은 2026년 '국가연구개발 행정제도개선(안)'을 수립해 국가 R&D 평가의 등급·점수제 폐지를 발표, 도전적 연구를 강조했습니다.
- 2022년 조사에서는 국내 대학의 83%가 여전히 JIF 가산점을 쓰고 있음.
- 한편으로, 논문으로밖에 실적을 낼 수 없는 기초과학 분야를 어떻게 평가할지에 대한 논의가 필요합니다.